Marble Minotaur
→ marble-report.html

Un rapport réel, lu pas à pas.

Le 23 septembre 2026, Marble Minotaur a audité l’instance de démonstration de Granit Golem, une application de supervision construite avec Vue, avec un compte de test. 60 écrans ouverts en 16 min 58 s. Granit Golem est un autre de mes projets : je le dis parce qu’un exemple choisi par l’auteur doit l’être ouvertement. Rien n’a été retouché, ni l’application avant, ni le rapport après. Voici ce qu’une équipe reçoit, dans l’ordre où elle le lit.

Ouvrir le rapport complet

Le vrai fichier, tel que l’équipe le reçoit (6,9 Mo). Version allégée : sans en-têtes HTTP, réponses ni captures.

Épisode · Du constat à la correction · 45 s Trop de bruit, les mêmes défauts cent fois : comment le rapport les ramène à une liste de corrections.
→ Synthèse

« Est-ce qu’on peut livrer ? »

Le verdict d’abord, et ce qu’il couvre.

La synthèse ouvre sur une phrase : deux défaillances bloquantes, observées sur les 60 écrans audités. Juste en dessous, ce que ce verdict ne peut pas dire : ce passage s’est fait en lecture seule, donc aucune commande n’a été actionnée et aucun enchaînement rejoué.

Un verdict qui tait ses limites se lit comme une garantie. Celui-ci les écrit.
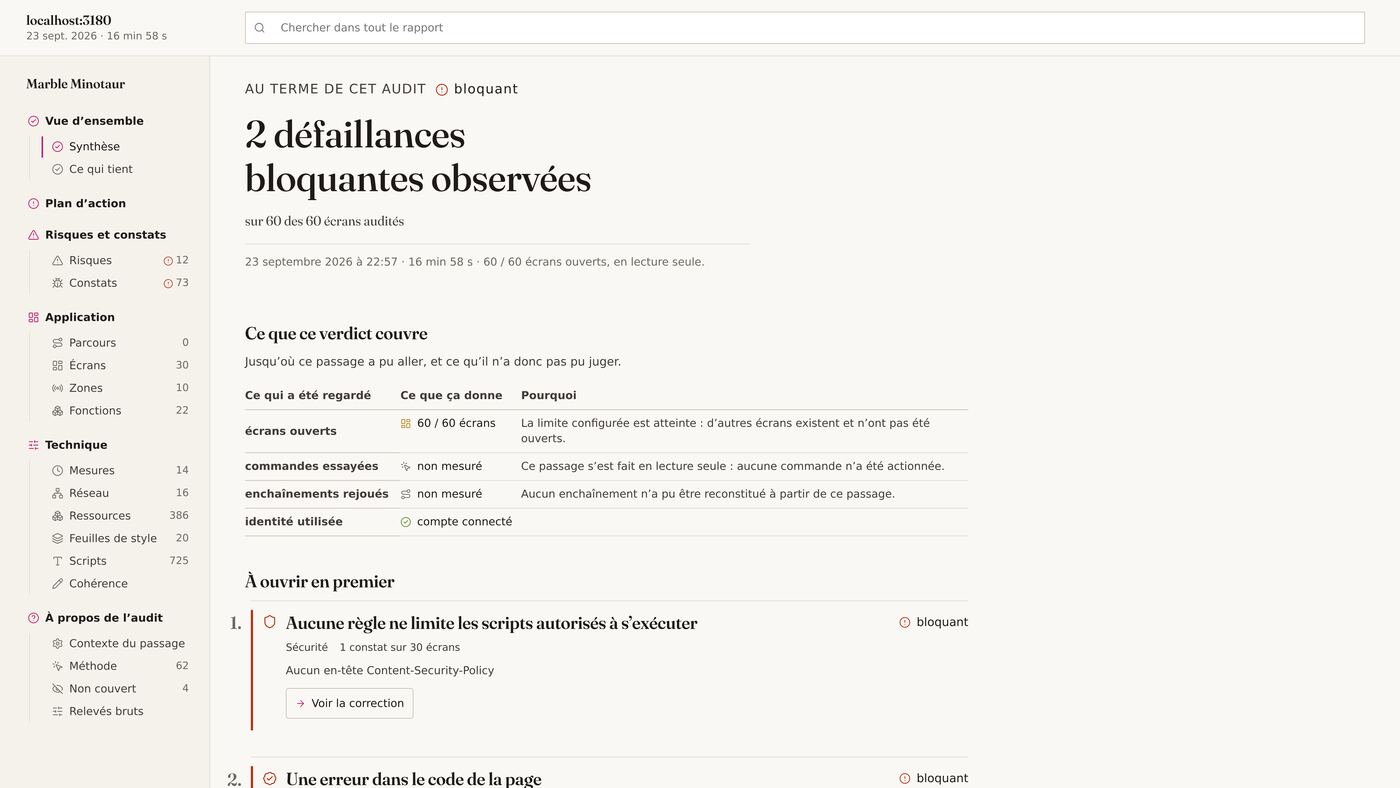
Synthèse : 2 défaillances bloquantes observées sur 60 des 60 écrans audités, et un tableau de ce que le verdict couvre
Au terme de cet audit : bloquant. Commandes essayées : non mesuré. Enchaînements rejoués : non mesuré.
→ Risques

« Qu’est-ce qui peut vraiment nous arriver ? »

Un risque, de bout en bout.

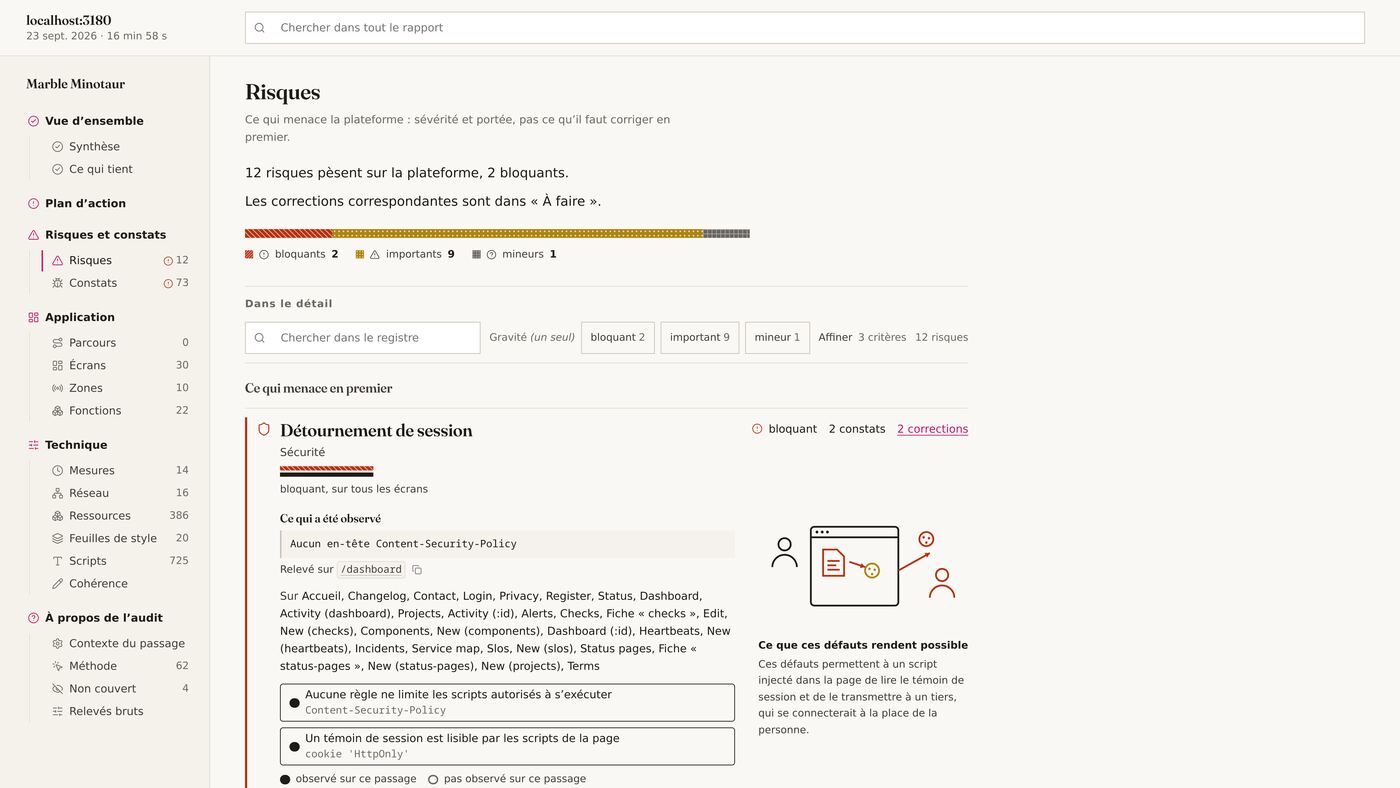
Deux défauts, pris séparément, ont l’air techniques. Ensemble, ils ouvrent une porte. Le rapport les relie en un risque nommé, dit où il a été vu, et explique en une phrase ce qu’il permettrait.

bloquant Détournement de session

Sécurité · sur tous les écrans · 2 constats · 2 corrections

Observé : aucune règle ne limite les scripts autorisés à s’exécuter (Content-Security-Policy), relevé sur /dashboard et les 29 autres écrans ; un témoin de session est lisible par les scripts de la page (HttpOnly absent).

Ce que ces défauts rendent possible : un script injecté dans la page lit le témoin de session et le transmet à un tiers, qui se connecterait à la place de la personne.

Onglet Risques : la carte du risque Détournement de session, avec son schéma
→ À faire

« Par quoi on commence lundi ? »

68 corrections, la plus rentable en premier.

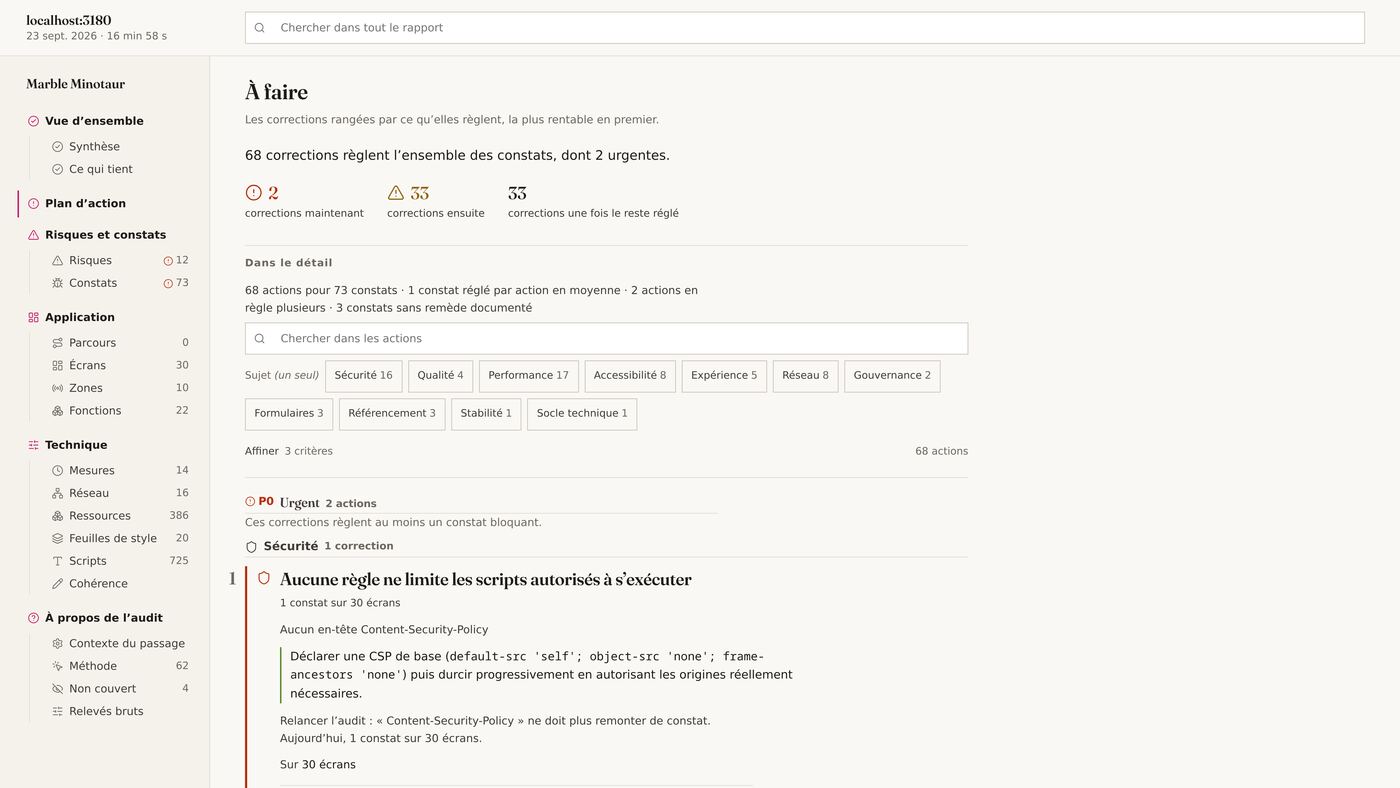
73 constats se ramènent à 68 corrections : 2 maintenant, 33 ensuite, 33 une fois le reste réglé. Chacune dit combien d’écrans elle répare, ce qu’il faut faire, et comment vérifier que c’est fait.

urgent Aucune règle ne limite les scripts autorisés à s’exécuter

1 constat sur 30 écrans · Sécurité

Faire : déclarer une politique de base (default-src 'self'; object-src 'none'; frame-ancestors 'none'), puis la durcir en autorisant les origines réellement nécessaires.

Vérifier : relancer l’audit ; « Content-Security-Policy » ne doit plus remonter de constat.

Onglet À faire : 68 corrections, 2 maintenant, 33 ensuite, 33 une fois le reste réglé
→ Ce qui tient

« Qu’est-ce qui marche, au moins ? »

Ce qui fonctionne, dit aussi nettement que le reste.

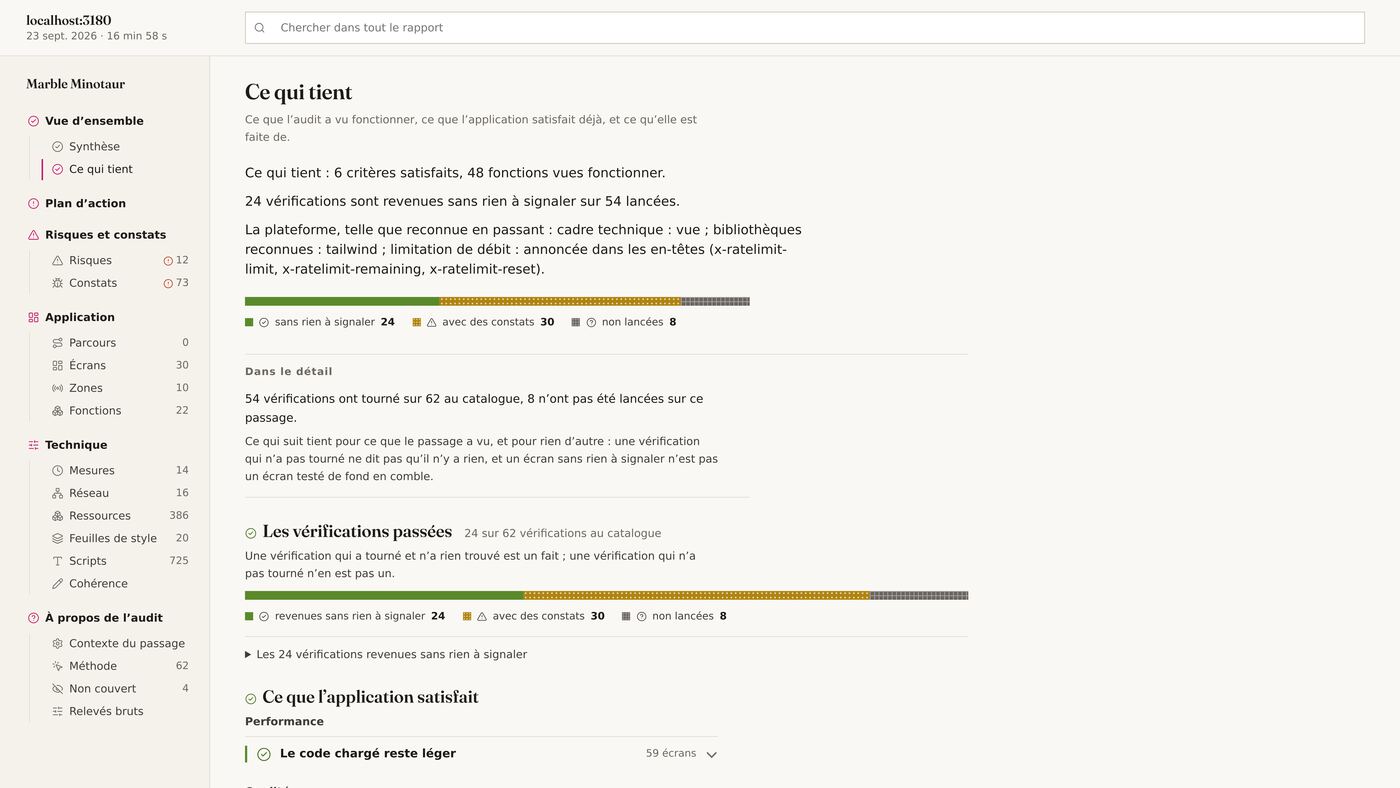
48 fonctions vues fonctionner, 6 critères satisfaits, 24 vérifications revenues sans rien à signaler sur 54 lancées. La plateforme reconnue en passant : Vue, Tailwind, une limitation de débit annoncée dans les en-têtes.

Et la nuance qui fait la différence : une vérification qui n’a pas tourné ne dit pas qu’il n’y a rien. Les 8 vérifications non lancées sont comptées à part, jamais parmi les réussites.

Onglet Ce qui tient : 6 critères satisfaits, 48 fonctions vues fonctionner, 24 vérifications sans rien à signaler sur 54
→ Fonctions

« Que fait vraiment notre application ? »

La carte des fonctions, sans lire le code.

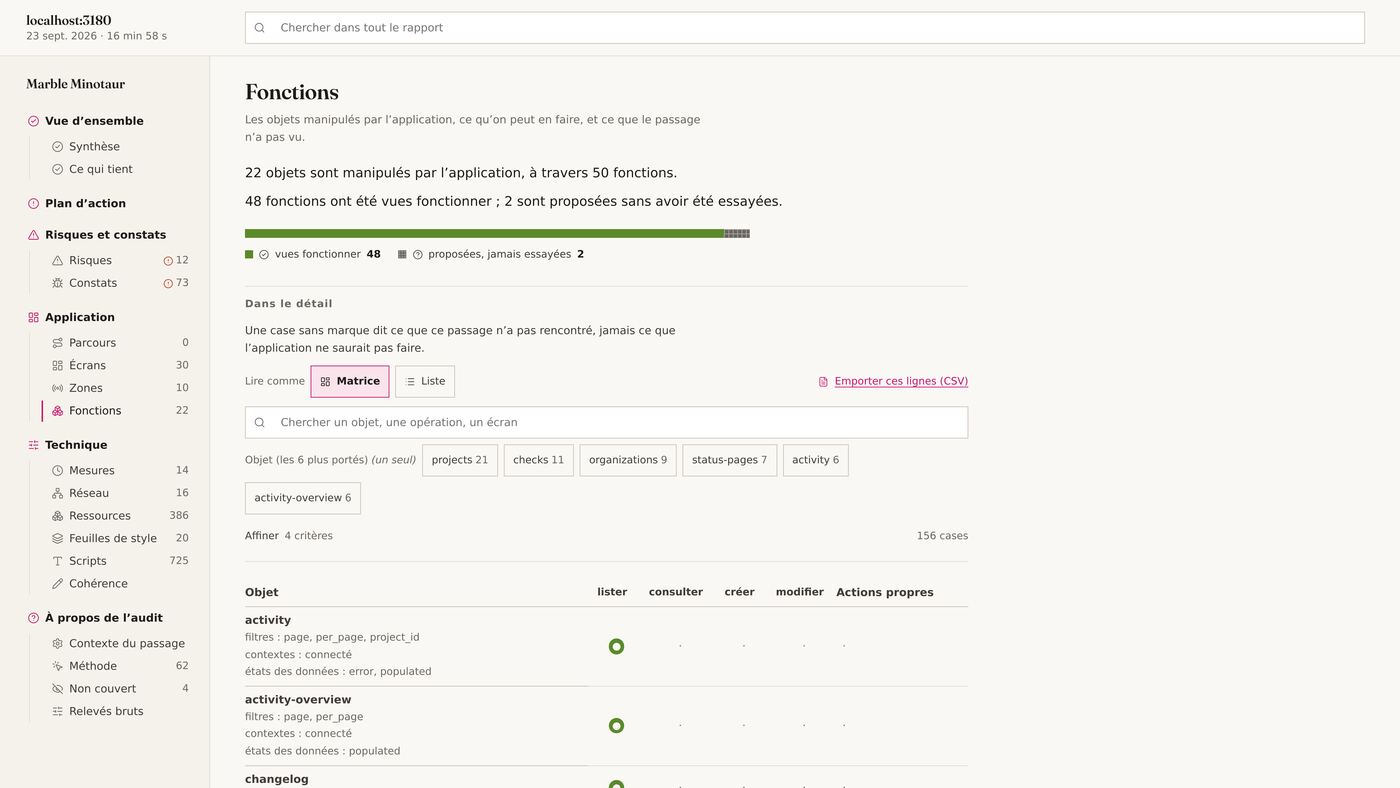
22 objets manipulés à travers 50 fonctions : lister, consulter, créer, modifier, et les actions propres à chaque objet. 48 ont été vues fonctionner, 2 sont proposées par l’interface sans avoir été essayées.

Une case vide dit ce que ce passage n’a pas rencontré, jamais ce que l’application ne saurait pas faire. La table s’exporte, pour la confronter à votre couverture de tests.

Onglet Fonctions : matrice des 22 objets et de leurs opérations, 48 vues fonctionner sur 50
→ Écrans

« Où est-ce que ça rame ? »

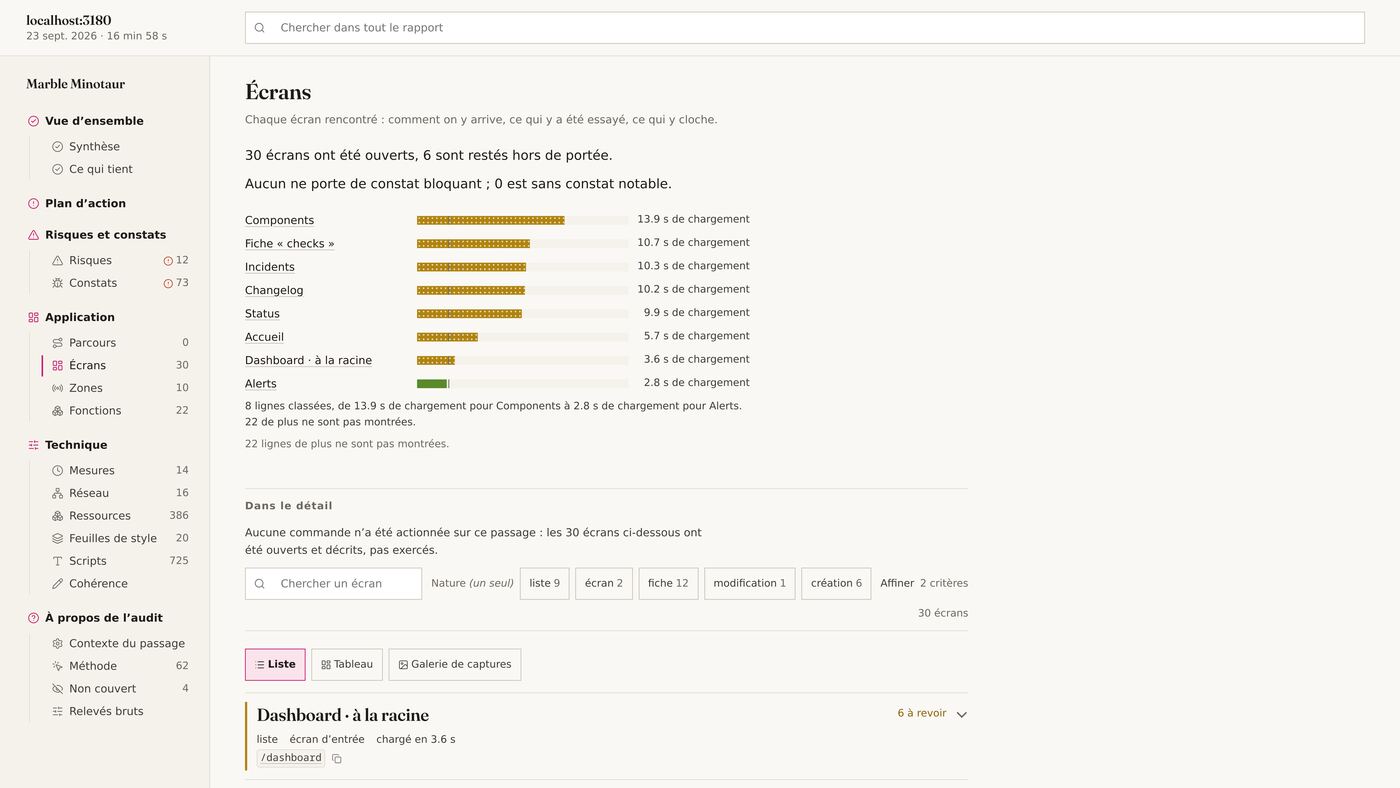
Chaque écran, avec son temps de chargement et ses défauts.

Les écrans rangés du plus lent au plus rapide, chacun avec sa capture annotée, ses trois tailles, les commandes essayées et ce qui y cloche. Ici, cinq écrans dépassent neuf secondes de chargement.

  • Components 13,9 s
  • Fiche « checks » 10,7 s
  • Incidents 10,3 s
  • Changelog 10,2 s
  • Status 9,9 s
  • Alerts 2,8 s
Onglet Écrans : les écrans classés par temps de chargement, de 13,9 s pour Components à 2,8 s pour Alerts
→ Mesures

« Est-ce que c’est rapide ? »

Chaque mesure comparée à son seuil.

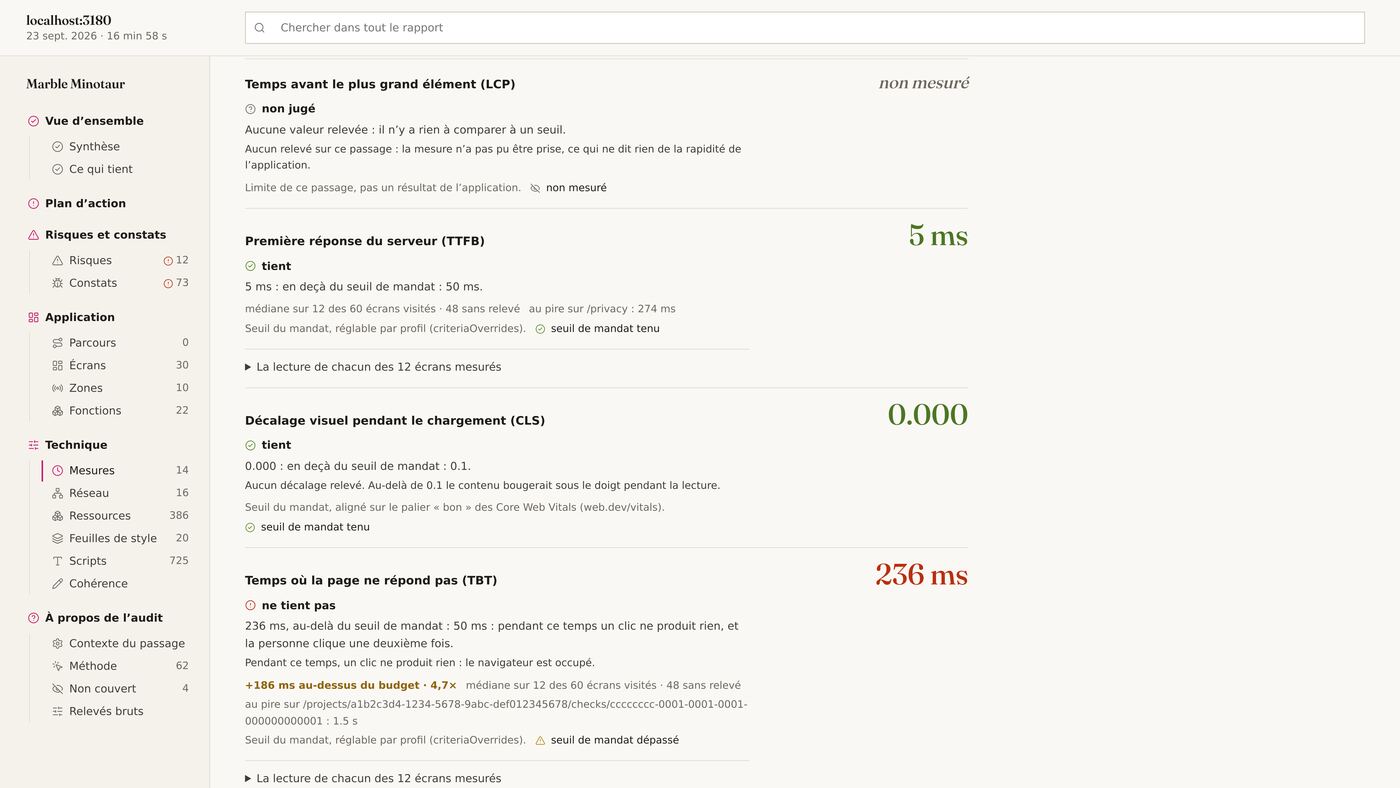
Une mesure n’est jugée que si elle a été prise. Quand elle ne l’a pas été, le rapport écrit « non mesuré » et précise que c’est une limite du passage, pas un résultat de l’application.

ne tient pas 236ms page qui ne répond pas, seuil 50 ms
tient 5ms première réponse, seuil 50 ms
non jugé ? plus grand élément : pas de relevé
Onglet Mesures : LCP non mesuré, TTFB 5 ms tient, CLS 0,000 tient, TBT 236 ms ne tient pas
→ Parcours

« Et ce qu’il n’a pas vu ? »

Ce qu’il n’a pas vu, et comment le voir la prochaine fois.

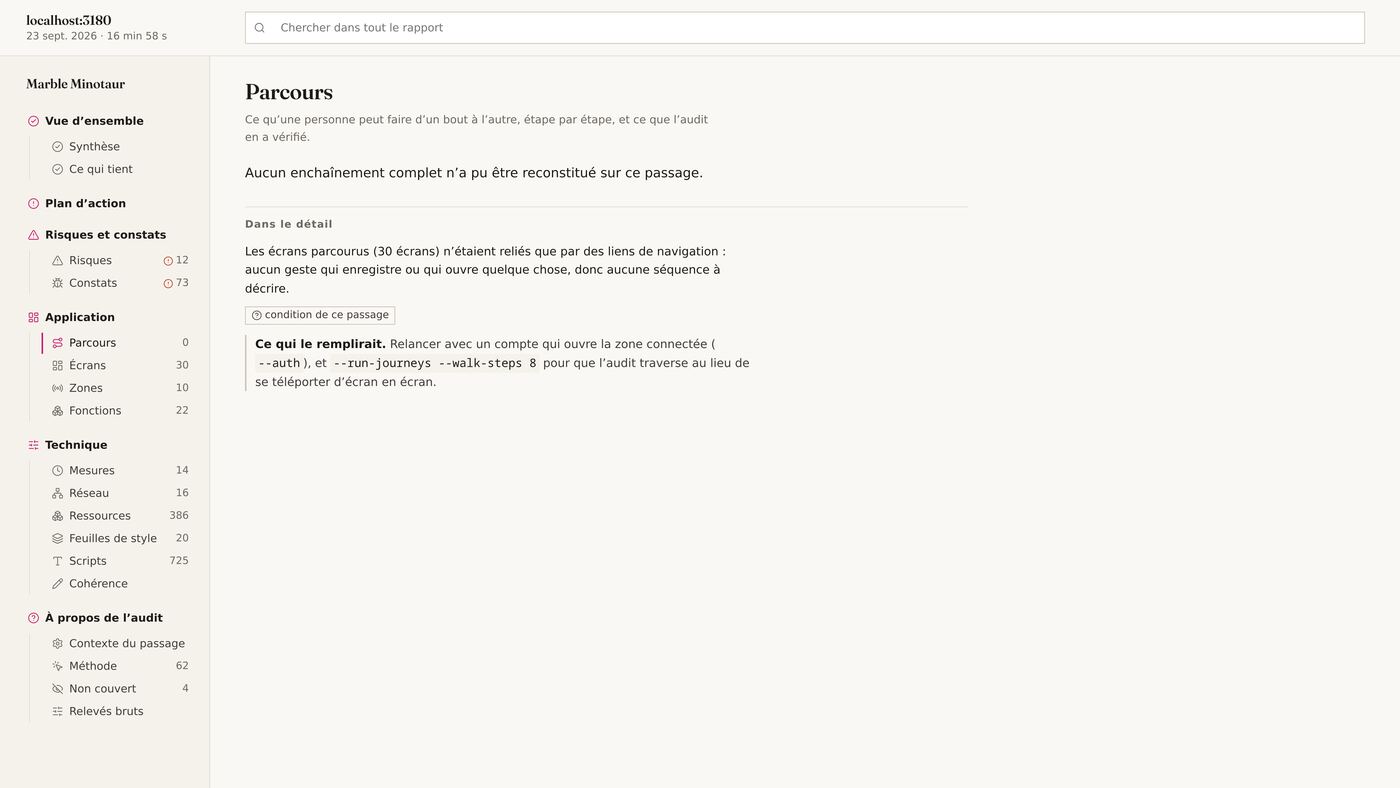
Sur ce passage en lecture seule, aucun enchaînement complet n’a pu être reconstitué. L’onglet ne se tait pas : il dit pourquoi, et quel réglage le remplirait au prochain passage.

Onglet Parcours : aucun enchaînement complet reconstitué, et ce qui le remplirait
« Ce qui le remplirait » : relancer avec les parcours rejoués activés.
→ 18

Dix-huit onglets, une question chacun.

Rangés en quatre groupes, du plus lu au plus technique. On peut s’arrêter au premier.

Lire

  • Synthèse : le verdict, ce qu’il couvre, quoi ouvrir en premier
  • À faire : les corrections, rangées par ce qu’elles règlent
  • Risques : ce qui menace, et ce que ça permettrait
  • Ce qui tient : ce qui a été vu fonctionner

Comprendre l’application

  • Parcours : les enchaînements observés et rejoués
  • Écrans : chaque écran, capturé et annoté
  • Zones : les parties de l’application et leurs règles
  • Fonctions : objets et opérations, vus ou seulement proposés

Vérifier en détail

  • Constats : chaque relevé, regroupé par famille
  • Cohérence : les appels comparés entre eux
  • Réseau : statuts, poids, formats, temps de réponse
  • Ressources : scripts, styles, images, polices
  • Mesures : chaque chiffre contre son seuil
  • Évolution : la comparaison avec le passage précédent

L’audit lui-même

  • Lecture extérieure : ce qu’un visiteur non connecté voit
  • Méthode : le catalogue, les réglages, un lexique
  • Non couvert : ce que ce passage n’a pas pu juger, et pourquoi
  • Relevés bruts : les données d’origine, pour vérifier
→ sortie

Il entre là où les autres s’arrêtent.

Le voyage ne s’active que sur demande. Envoyez-moi trois choses, vous recevez le rapport.

  • L’adresse de l’application, en préproduction de préférence
  • Un compte de test, avec les droits d’un utilisateur ordinaire
  • Le périmètre lecture seule, ou formulaires et clics autorisés
cedric@siliceum.com

Ce qui se passe ensuite

  1. Vous m’écrivez l’adresse et le périmètre. Le compte de test arrive à part, jamais dans le courriel.
  2. Je lance le passage et je relis le rapport avant de vous l’envoyer.
  3. On le lit ensemble, une demi-heure en visio, pour que votre équipe sache par où commencer.

Les premiers passages sont offerts, relecture comprise, aux équipes qui acceptent de me dire ensuite ce qui leur a manqué dans le rapport.